Многопоточные вычисления в php: pthreads
Содержание:
- Creating Thread Using Threading Module
- Особенности реализации
- Создание потока управления
- Условные переменные
- Создание и ожидание потока
- Поток жизненного цикла в Java
- Что такое Single Thread?
- Создание потока ядра
- Описание
- Synchronizing Threads
- Multithreaded Priority Queue
- Проблемы, которые создает многопоточность
- Многопоточность
- Starting a Task with CompletableFutures
- Заключение
Creating Thread Using Threading Module
To implement a new thread using the threading module, you have to do the following −
-
Define a new subclass of the Thread class.
-
Override the __init__(self ) method to add additional arguments.
-
Then, override the run(self ) method to implement what the thread should do when started.
Once you have created the new Thread subclass, you can create an instance of it and then start a new thread by invoking the start(), which in turn calls the run() method.
Example
#!/usr/bin/python3

import threading
import time

exitFlag = 0

class myThread (threading.Thread):
   def __init__(self, threadID, name, counter):
      threading.Thread.__init__(self)
      self.threadID = threadID
      self.name = name
      self.counter = counter
   def run(self):
      print ("Starting " + self.name)
      print_time(self.name, self.counter, 5)
      print ("Exiting " + self.name)

def print_time(threadName, delay, counter):
   while counter:
      if exitFlag:
         threadName.exit()
      time.sleep(delay)
      print ("%s: %s" % (threadName, time.ctime(time.time())))
      counter -= 1

# Create new threads
thread1 = myThread(1, "Thread-1", 1)
thread2 = myThread(2, "Thread-2", 2)

# Start new Threads
thread1.start()
thread2.start()
thread1.join()
thread2.join()
print ("Exiting Main Thread")
Result
When we run the above program, it produces the following result −
Starting Thread-1
Starting Thread-2
Thread-1: Fri Feb 19 10:00:21 2016
Thread-2: Fri Feb 19 10:00:22 2016
Thread-1: Fri Feb 19 10:00:22 2016
Thread-1: Fri Feb 19 10:00:23 2016
Thread-2: Fri Feb 19 10:00:24 2016
Thread-1: Fri Feb 19 10:00:24 2016
Thread-1: Fri Feb 19 10:00:25 2016
Exiting Thread-1
Thread-2: Fri Feb 19 10:00:26 2016
Thread-2: Fri Feb 19 10:00:28 2016
Thread-2: Fri Feb 19 10:00:30 2016
Exiting Thread-2
Exiting Main Thread
Особенности реализации
Важнейшей областью исследований является планировщик потоков, который должен быстро выбрать из списка готовых к запуску потоков для выполнения следующего, а также поддерживать готовые к запуску и остановленные списки потоков
Важной подтемой являются различные схемы приоритетов потоков, которые могут использоваться планировщиком. Планировщик потоков может быть полностью реализован в программном обеспечении, полностью на аппаратном уровне или в виде аппаратно-программной комбинации.
Еще одной областью исследований является то, какие типы событий должны вызывать переключение потоков: потери в кэш-памяти, межпотоковая связь, завершение DMA и т.д.
Если многопоточная схема копирует все видимое программное обеспечение, включая привилегированные регистры управления и TLB, то она позволяет создавать виртуальные машины для каждого потока. Это позволяет каждому потоку запускать свою собственную операционную систему на одном процессоре. С другой стороны, если сохраняется только состояние пользовательского режима, требуется меньшее количество аппаратного обеспечения, что позволило бы одновременно активизировать несколько потоков для одной и той же области кристалла.
Создание потока управления
 int pthread_create (pthread_t *tid_p, const pthread_attr_t *attr_p,
		void *(*func_p)(void *), void *arg_p)
Создает новый поток для функции, заданной параметром func_p. Эта функция имеет аргументом указатель (void *) и возвращает значение того же типа. Реально же в функцию передается аргумент arg_p. Идентификатор нового потока возвращается через tid_p.
Аргумент attr_p указывает на структуру, задающую атрибуты вновь создаваемого потока. Если attr_p=NULL, то используются атрибуты «по умолчанию» (но это плохая практика, т.к. в разных ОС эти значения могут быть различными, хотя декларируется обратное). Одна структура, указываемая attr_p, может использоваться для управления несколькими потоками.
Условные переменные
Применяются в сочетании со взаимоис
ключающими блокировками. Общая схема использования такова. Один поток устанавливает взаимоисключающую блокировку и затем блокирует себя по условной переменной (путем вызова функции pthread_cond_wait()), при этом автоматически (но временно) освобождается взаимоисключающая блокировка. Когда какой-либо другой поток посредством вызова функции pthread_cond_signal() сигнализирует по условной переменной, то первый поток разблокируется и ему возвращается во владение взаимоисключающая блокировка.
int pthread_cond_init (pthread_cond_t *cvp, const pthread_condattr_t *cattrp)
инициализирует условную переменную, выделяя память.
int pthread_cond_destroy (pthread_cond_t *cvp)
разрушает условную переменную, освобождая память.
int pthread_cond_wait (pthread_cond_t *cvp, const pthread_mutex_t *mp)
автоматически освобождает взаимоисключающую блокировку, указанную mp, а вызывающий поток блокируется по условной переменной, заданной cvp. Заблокированный поток разблокируется функциями pthread_cond_signal() и pthread_cond_broadcast(). Одной условной переменной могут быть заблокированы несколько потоков.
int pthread_cond_timedwait (pthread_cond_t *cvp, const pthread_mutex_t *mp, struct timespec *tp)
аналогична функции pthread_cond_wait(), но имеет третий аргумент, задающий интервал времени, после которого поток разблокируется (если этого не было сделано ранее).
int pthread_cond_signal (pthread_cond_t *cvp)
разблокирует ожидающий данную условную переменную поток. Если сигнала по условной переменной ожидают несколько потоков, то будет разблокирован только какой-либо один из них.
int pthread_cond_broadcast (pthread_cond_t *cvp)
разблокирует все потоки, ожидающие данную условную переменную.
Создание и ожидание потока
Рассмотрим простой пример
#include <stdio.h>
#include <stdlib.h>
#include <pthread.h>
#include <conio.h>

#define ERROR_CREATE_THREAD -11
#define ERROR_JOIN_THREAD   -12
#define SUCCESS		   0

void* helloWorld(void *args) {
	printf("Hello from thread!\n");
	return SUCCESS;
}

int main() {
	pthread_t thread;
	int status;
	int status_addr;

	status = pthread_create(&thread, NULL, helloWorld, NULL);
	if (status != 0) {
		printf("main error: can't create thread, status = %d\n", status);
		exit(ERROR_CREATE_THREAD);
	}
	printf("Hello from main!\n");

	status = pthread_join(thread, (void**)&status_addr);
	if (status != SUCCESS) {
		printf("main error: can't join thread, status = %d\n", status);
		exit(ERROR_JOIN_THREAD);
	}

	printf("joined with address %d\n", status_addr);
	_getch();
	return 0;
}
В данном примере внутри основного потока, в котором работает функция main, создаётся новый поток, внутри которого вызывается функция helloWorld. Функция helloWorld выводит на
дисплей приветствие. Внутри основного потока также выводится приветствие. Далее потоки объединяются.
Новый поток создаётся с помощью функции pthread_create
int pthread_create(*ptherad_t, const pthread_attr_t *attr, void* (*start_routine)(void*), void *arg);
Функция получает в качестве аргументов указатель на поток, переменную типа pthread_t, в которую, в случае удачного завершения сохраняет id потока. pthread_attr_t – атрибуты потока.
В случае если используются атрибуты по умолчанию, то можно передавать NULL. start_routin – это непосредственно та функция, которая будет выполняться в новом потоке. arg – это
аргументы, которые будут переданы функции.
Поток может выполнять много разных дел и получать разные аргументы. Для этого функция, которая будет запущена в новом потоке, принимает аргумент типа void*. За счёт этого можно обернуть все передаваемые аргументы в структуру. Возвращать значение можно также через передаваемый аргумент.
В случае успешного выполнения функция возвращает 0. Если произошли ошибки, то могут быть возвращены следующие значения
-
EAGAIN – у системы нет ресурсов для создания нового потока, или система не может больше создавать потоков, так как количество потоков превысило значение
PTHREAD_THREADS_MAX (например, на одной из машин, которые используются для тестирования, это магическое число равно 2019) - EINVAL – неправильные атрибуты потока (переданные аргументом attr)
- EPERM – Вызывающий поток не имеет должных прав для того, чтобы задать нужные параметры или политики планировщика.
Пройдём по программе
#define ERROR_CREATE_THREAD -11
#define ERROR_JOIN_THREAD   -12
#define SUCCESS		   		  0
Здесь мы задаём набор значений, необходимый для обработки возможных ошибок.
void* helloWorld(void *args) {
	printf("Hello from thread!\n");
	return SUCCESS;
}
Это функция, которая будет работать в отдельном потоке. Она не будет получать никаких аргументов. По стандарту считается, что явный выход из функции вызывает функцию pthread_exit, а возвращаемое значение будет передано при вызове функции pthread_join, как статус.
status = pthread_create(&thread, NULL, helloWorld, NULL);
if (status != 0) {
	printf("main error: can't create thread, status = %d\n", status);
	exit(ERROR_CREATE_THREAD);
}
Здесь создаётся и сразу же исполняется новый поток. Поток не получает никаких атрибутов или аргументов. После создания потока происходит проверка на ошибку.
Вызов
status = pthread_join(thread, (void**)&status_addr);
if (status != SUCCESS) {
	printf("main error: can't join thread, status = %d\n", status);
	exit(ERROR_JOIN_THREAD);
}
Приводит к тому, что основной поток будет ждать завершения порождённого. Функция
int pthread_join(pthread_t thread, void **value_ptr);
Откладывает выполнение вызывающего (эту функцию) потока, до тех пор, пока не будет выполнен поток thread. Когда pthread_join выполнилась успешно, то она возвращает 0.
Если поток явно вернул значение (это то самое значение SUCCESS, из нашей функции), то оно будет помещено в переменную value_ptr.
Возможные ошибки, которые возвращает pthread_join
- EINVAL – thread указывает на не объединяемый поток
- ESRCH – не существует потока с таким идентификатором, который хранит переменная thread
- EDEADLK – был обнаружен дедлок (взаимная блокировка), или же в качестве объединяемого потока указан сам вызывающий поток.
Поток жизненного цикла в Java
Жизненный цикл потока:

Существуют различные этапы жизненного цикла потока, как показано на диаграмме выше:
Некоторые из часто используемых методов для потоков:
Пример: в этом примере мы собираемся создать поток и исследовать встроенные методы, доступные для потоков.
package demotest;
public class thread_example1 implements Runnable {
    @Override
    public void run() {
    }
    public static void main(String[] args) {
        Thread guruthread1 = new Thread();
        guruthread1.start();
        try {
            guruthread1.sleep(1000);
        } catch (InterruptedException e) {
            // TODO Auto-generated catch block
            e.printStackTrace();
        }
        guruthread1.setPriority(1);
        int gurupriority = guruthread1.getPriority();
        System.out.println(gurupriority);
        System.out.println("Thread Running");
  }
}
Пояснение к коду:
- Строка кода 2: Мы создаем класс “thread_Example1”, который реализует интерфейс Runnable (он должен быть реализован любым классом, экземпляры которого предназначены для выполнения потоком.)
- Строка кода 4: переопределяет метод run интерфейса runnable, так как этот метод является обязательным
- Строка кода 6: Здесь мы определили основной метод, в котором мы начнем выполнение потока.
- Строка кода 7: Здесь мы создаем новое имя потока как «guruthread1», создавая новый класс потока.
- Строка кода 8: мы будем использовать метод «start» потока, используя экземпляр «guruthread1». Здесь поток начнет выполняться.
- Строка кода 10: Здесь мы используем метод «сна» потока, используя экземпляр «guruthread1». Следовательно, поток будет спать в течение 1000 миллисекунд.
- Код 9-14: Здесь мы поместили спящий метод в блок try catch, поскольку существует проверенное исключение, которое возникает, т.е. исключение Interrupted.
- Строка кода 15: устанавливаем приоритет потока в 1 от того, какой приоритет был
- Строка кода 16: получаем приоритет потока, используя getPriority()
- Строка кода 17: печатаем значение, полученное из getPriority
- Строка кода 18: пишем текст, запущенный потоком.
Когда вы выполните приведенный выше код, вы получите следующий вывод:

Вывод:
5 – это приоритет Thread, а Thread Running – текст, который является выводом нашего кода.
Что такое Single Thread?
Одиночная нить – это в основном легкая и самая маленькая единица обработки. Java использует потоки, используя «класс потоков».
Существует два типа потока – пользовательский поток и поток демона (потоки демона используются, когда мы хотим очистить приложение, и используются в фоновом режиме).
Когда приложение только начинается, создается пользовательский поток. Опубликовать это, мы можем создать много пользовательских потоков.
Пример с одной нитью:
package demotest;

public class GuruThread
{
       public static void main(String[] args) {
              System.out.println("Single Thread");
       }
}
Преимущества одной нити:
- Уменьшает накладные расходы в приложении при выполнении одного потока в системе
- Кроме того, это снижает стоимость обслуживания приложения.
Создание потока ядра
Для создания нового потока ядра используется вызов:
int kernel_thread( int (*fn)(void *), void *arg, unsigned long flags );
Параметры такого вызова понятны: функция потока, безтиповой указатель — параметр,
передаваемый этой функции, и флаги, обычные для Linux вызова .
Возвращаемое функцией значение — это
вновь созданного потока (в случае успешного создания его значение будет больше нуля, а отрицательное
значение — это код ошибки).
Этот же вызов можно найти и среди экспортируемых символов ядра:
$ cat /proc/kallsyms | grep kernel_thread
c0407c44 T kernel_thread
...
Ранее, при рассмотрении обработчиков прерываний, уже был затронут механизм рабочих очередей (workqueue),
обслуживаемый потоками ядра. Как должно быть понятно, наличия одного такого механизма высокого уровня уже достаточно для
инициации параллельных действий в ядре (с неявным использованием потоков ядра). Сейчас же мы
рассмотрим только низкоуровневые механизмы, лежащие в основе той функциональности.
В листинге 1 представлен простейший пример создания потоков ядра. Полный код примера можно найти в
модуле mod_thr1 в архиве thread.tgz в разделе «Материалы для скачивания».
Листинг 1. Создание потоков ядра (файл mod_thr1.c)
#include <linux/module.h>
#include <linux/sched.h>
#include <linux/delay.h>

static int param = 3;
module_param( param, int, 0 );

static int thread( void * data ) {
   printk( KERN_INFO "thread: child process  is running\n", current->pid );
   ssleep( param ); /* пауза на 3 с или на период, указанный в параметре */
   printk( KERN_INFO "thread: child process  is completed\n", current->pid );
   return 0;
}

int test_thread( void ) {
   pid_t pid;
   printk( KERN_INFO "thread: main process  is running\n", current->pid );
   pid = kernel_thread( thread, NULL, CLONE_FS ); /* запускаем новый поток */
   ssleep( 5 );                                   /* пауза 5 с. */
   printk( KERN_INFO "thread: main process  is completed\n", current->pid );
   return -1;
}

module_init( test_thread );
Этот модуль ядра ничего не выполняет, за исключением того, что запускает новый поток ядра.
При выполнении этого примера будет выведена подобная информация:
$ uname -r
2.6.32.9-70.fc12.i686.PAE
$ time sudo insmod ./mod_thr1.ko
insmod: error inserting './mod_thr1.ko': -1 Operation not permitted
real	0m5.025s
user	0m0.004s
sys	0m0.012s
$ sudo cat /var/log/messages | tail -n30 | grep thread:
Jul 24 18:43:57 notebook kernel: thread: main process  is running
Jul 24 18:43:57 notebook kernel: thread: child process  is running
Jul 24 18:44:00 notebook kernel: thread: child process  is completed
Jul 24 18:44:02 notebook kernel: thread: main process  is completed
Если выполнить пример с задержкой дочернего процесса больше, чем у родительского, то после завершения
запуска (при завершении созданного потока ядра!) будет выведено критическое сообщение об ошибке ядра:
$ sudo insmod ./mod_thr1.ko param=7
insmod: error inserting './mod_thr1.ko': -1 Operation not permitted
$
Message from syslogd@notebook at Jul 24 18:51:00 ...
 kernel:Oops: 0002  SMP
...
$ sudo cat /var/log/messages | tail -n70 | grep thread:
Jul 24 18:50:53 notebook kernel: thread: main process  is running
Jul 24 18:50:53 notebook kernel: thread: child process  is running
Jul 24 18:50:58 notebook kernel: thread: main process  is completed
Последний параметр вызова
определяет детальный, побитово устанавливаемый набор свойств, которыми будет обладать созданный поток ядра,
так как это делается в практике Linux при вызове
(при создании потоков-процессов в Linux наблюдается существенное отличие от традиций UNIX/POSIX).
Часто в коде модулей можно видеть создание потока с таким набором флагов:
kernel_thread( thread_function, NULL, CLONE_FS | CLONE_FILES | CLONE_SIGHAND | SIGCHLD );
Описание
Многопоточная парадигма стала более популярной с конца 1990-х годов, поскольку усилия по дальнейшему использованию параллелизма на уровне инструкций застопорились.
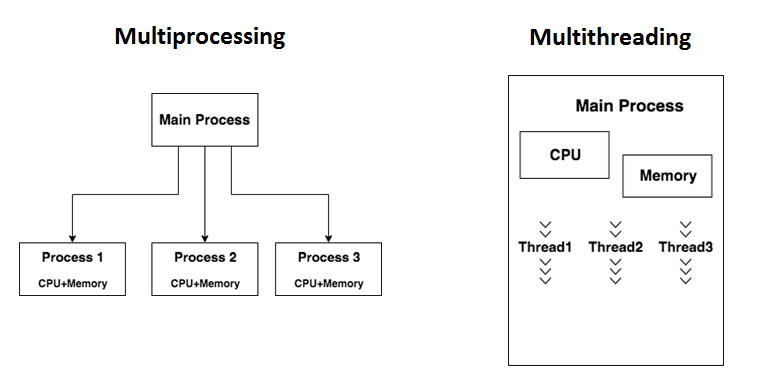
Смысл многопоточности — квазимногозадачность на уровне одного исполняемого процесса. Значит, все потоки процесса помимо общего адресного пространства имеют и общие дескрипторы файлов. Выполняющийся процесс имеет как минимум один (главный) поток.
Многопоточность (как доктрину программирования) не следует путать ни с многозадачностью, ни с многопроцессорностью, несмотря на то, что операционные системы, реализующие многозадачность, как правило, реализуют и многопоточность.
Достоинства
- облегчение программы посредством использования общего адресного пространства.
- меньшие затраты на создание потока в сравнении с процессами.
- повышение производительности процесса за счёт распараллеливания процессорных вычислений.
- если поток часто теряет кэш, другие потоки могут продолжать использовать неиспользованные вычислительные ресурсы.
Недостатки
- несколько потоков могут вмешиваться друг в друга при совместном использовании аппаратных ресурсов
- с программной точки зрения аппаратная поддержка многопоточности более трудоемка для программного обеспечения
- проблема планирования потоков
- специфика использования. Вручную настроенные программы на ассемблере, использующие расширения MMX или AltiVec и выполняющие предварительные выборки данных, не страдают от потерь кэша или неиспользуемых вычислительных ресурсов. Таким образом, такие программы не выигрывают от аппаратной многопоточности и действительно могут видеть ухудшенную производительность из-за конкуренции за общие ресурсы.
Synchronizing Threads
The threading module provided with Python includes a simple-to-implement locking mechanism that allows you to synchronize threads. A new lock is created by calling the Lock() method, which returns the new lock.
The acquire(blocking) method of the new lock object is used to force the threads to run synchronously. The optional blocking parameter enables you to control whether the thread waits to acquire the lock.
If blocking is set to 0, the thread returns immediately with a 0 value if the lock cannot be acquired and with a 1 if the lock was acquired. If blocking is set to 1, the thread blocks and wait for the lock to be released.
The release() method of the new lock object is used to release the lock when it is no longer required.
Example
#!/usr/bin/python3

import threading
import time

class myThread (threading.Thread):
   def __init__(self, threadID, name, counter):
      threading.Thread.__init__(self)
      self.threadID = threadID
      self.name = name
      self.counter = counter
   def run(self):
      print ("Starting " + self.name)
      # Get lock to synchronize threads
      threadLock.acquire()
      print_time(self.name, self.counter, 3)
      # Free lock to release next thread
      threadLock.release()

def print_time(threadName, delay, counter):
   while counter:
      time.sleep(delay)
      print ("%s: %s" % (threadName, time.ctime(time.time())))
      counter -= 1

threadLock = threading.Lock()
threads = []

# Create new threads
thread1 = myThread(1, "Thread-1", 1)
thread2 = myThread(2, "Thread-2", 2)

# Start new Threads
thread1.start()
thread2.start()

# Add threads to thread list
threads.append(thread1)
threads.append(thread2)

# Wait for all threads to complete
for t in threads:
   t.join()
print ("Exiting Main Thread")
Output
When the above code is executed, it produces the following result −
Starting Thread-1
Starting Thread-2
Thread-1: Fri Feb 19 10:04:14 2016
Thread-1: Fri Feb 19 10:04:15 2016
Thread-1: Fri Feb 19 10:04:16 2016
Thread-2: Fri Feb 19 10:04:18 2016
Thread-2: Fri Feb 19 10:04:20 2016
Thread-2: Fri Feb 19 10:04:22 2016
Exiting Main Thread
Multithreaded Priority Queue
The Queue module allows you to create a new queue object that can hold a specific number of items. There are following methods to control the Queue −
-
get() − The get() removes and returns an item from the queue.
-
put() − The put adds item to a queue.
-
qsize() − The qsize() returns the number of items that are currently in the queue.
-
empty() − The empty( ) returns True if queue is empty; otherwise, False.
-
full() − the full() returns True if queue is full; otherwise, False.
Example
#!/usr/bin/python

import Queue
import threading
import time

exitFlag = 0

class myThread (threading.Thread):
   def __init__(self, threadID, name, q):
      threading.Thread.__init__(self)
      self.threadID = threadID
      self.name = name
      self.q = q
   def run(self):
      print "Starting " + self.name
      process_data(self.name, self.q)
      print "Exiting " + self.name

def process_data(threadName, q):
   while not exitFlag:
      queueLock.acquire()
         if not workQueue.empty():
            data = q.get()
            queueLock.release()
            print "%s processing %s" % (threadName, data)
         else:
            queueLock.release()
         time.sleep(1)

threadList =
nameList =
queueLock = threading.Lock()
workQueue = Queue.Queue(10)
threads = []
threadID = 1

# Create new threads
for tName in threadList:
   thread = myThread(threadID, tName, workQueue)
   thread.start()
   threads.append(thread)
   threadID += 1

# Fill the queue
queueLock.acquire()
for word in nameList:
   workQueue.put(word)
queueLock.release()

# Wait for queue to empty
while not workQueue.empty():
   pass

# Notify threads it's time to exit
exitFlag = 1

# Wait for all threads to complete
for t in threads:
   t.join()
print "Exiting Main Thread"
When the above code is executed, it produces the following result −
Starting Thread-1
Starting Thread-2
Starting Thread-3
Thread-1 processing One
Thread-2 processing Two
Thread-3 processing Three
Thread-1 processing Four
Thread-2 processing Five
Exiting Thread-3
Exiting Thread-1
Exiting Thread-2
Exiting Main Thread
Previous Page
Print Page
Next Page
Проблемы, которые создает многопоточность
Deadlock
- Поток-1 перестанет работать с Объектом-1 и переключится на Объект-2, как только Поток-2 перестанет работать с Объектом 2 и переключится на Объект-1.
- Поток-2 перестанет работать с Объектом-2 и переключится на Объект-1, как только Поток-1 перестанет работать с Объектом 1 и переключится на Объект-2.
Потоки никогда не поменяются местами и будут ждать друг друга вечно. deadlock
Поток-0 достает яйца из холодильника.
Поток-1 включает плиту.
Поток-2 достает сковородку и ставит на плиту.
Поток-3 зажигает огонь на плите.
Поток-4 выливает на сковороду масла.
Поток-5 разбивает яйца и выливает их на сковороду.
Поток-6 выбрасывает скорлупу в мусорное ведро.
Поток-7 снимает готовую яичницу с огня.
Поток-8 выкладывает яичницу в тарелку.
Поток-9 моет посуду.Выполнен поток Thread-0
Выполнен поток Thread-2
Выполнен поток Thread-1
Выполнен поток Thread-4
Выполнен поток Thread-9
Выполнен поток Thread-5
Выполнен поток Thread-8
Выполнен поток Thread-7
Выполнен поток Thread-3
Выполнен поток Thread-6
Многопоточность
Основная статья: Многопоточность
Многопоточность, как широко распространённая модель программирования и исполнения кода, позволяет нескольким потокам выполняться в рамках одного процесса. Эти потоки выполнения совместно используют ресурсы процесса, но могут работать и самостоятельно. Многопоточная модель программирования предоставляет разработчикам удобную абстракцию параллельного выполнения. Однако, пожалуй, наиболее интересное применение технологии имеется в том случае, когда она применяется к одному процессу, что позволяет его параллельное выполнение на многопроцессорной системе.
Это преимущество многопоточной программы позволяет ей работать быстрее на компьютерных системах, которые имеют несколько процессоров, процессор с несколькими ядрами или на кластере машин — из-за того, что потоки выполнения программ естественным образом поддаются действительно параллельному выполнению процессов. В этом случае программисту нужно быть очень осторожным, чтобы избежать состояния гонки, и другого неинтуитивного поведения. Для того, чтобы правильно манипулировать данными, потоки выполнения должны часто проходить через процедуру рандеву, чтобы обрабатывать данные в правильном порядке. Потокам выполнения могут также потребоваться мьютексы (которые часто реализуются с использованием семафоров), чтобы предотвратить одновременное изменение общих данных или их чтение во время процесса изменения
Неосторожное использование таких примитивов может привести к тупиковой ситуации.
Другим использованием многопоточности, применяемым даже для однопроцессорных систем, является возможность для приложения реагирования на ввод данных. В однопоточных программах, если основной поток выполнения заблокирован выполнением длительной задачи, всё приложение может оказаться в замороженном состоянии. Перемещая такие длительные задачи в рабочий поток, который выполняется параллельно с основным потоком, становится возможным для приложений продолжать реагировать на действия пользователя во время выполнения задач в фоновом режиме. С другой стороны, в большинстве случаев многопоточность — не единственный способ сохранить чувствительность программы. То же самое может быть достигнуто через асинхронный ввод-вывод или сигналы в UNIX.
Операционные системы планируют выполнение потоков одним из двух способов:
- Приоритетная многопоточность, вообще говоря, считается более совершенным подходом, так как она позволяет операционной системе определить, когда должно происходить переключение контекста. Недостаток приоритетной многопоточности состоит в том, что система может сделать переключение контекста в неподходящее время, что приводит к инверсии приоритета и другим негативным эффектам, которых можно избежать, применяя кооперативную многопоточность.
- Кооперативная многопоточность полагается на сами потоки и отказывается от управления, если потоки выполнения находятся в точках остановки. Это может создать проблемы, если поток выполнения ожидает ресурс, пока он не станет доступным.
До конца 1990-х процессоры в настольных компьютерах не имели поддержки многопоточности, так как переключение между потоками, как правило, происходило медленнее, чем полное переключение контекста процесса. Процессоры во встраиваемых системах, которые имеют более высокие требования к поведению в реальном времени, могут поддерживать многопоточность за счёт уменьшения времени на переключение между потоками, возможно, путём распределения выделенных регистровых файлов для каждого потока выполнения, вместо сохранения/восстановления общего регистрового файла. В конце 1990-х идея выполнения инструкций нескольких потоков одновременно, известная как одновременная многопоточность, под названием Hyper-Threading, достигла настольных компьютеров с процессором Intel Pentium 4. Потом она была исключена из процессоров архитектуры Intel Core и Core 2, но позже восстановлена в архитектуре Core i7.
Критики многопоточности утверждают, что увеличение использования потоков имеет существенные недостатки:
Starting a Task with CompletableFutures
To retrieve the final result from a Future object we can use the get method available in the object, but this would block the parent thread until the end of the computation.
Alternatively, we could avoid the block by adding more logic to our task, but we have to increase the complexity of our code.
Java 1.8 introduced a new framework on top of the Future construct to better work with the computation’s result: the CompletableFuture.
CompletableFuture implements CompletableStage, which adds a vast selection of methods to attach callbacks and avoid all the plumbing needed to run operations on the result after it’s ready.
The implementation to submit a task is a lot simpler:
supplyAsync takes a Supplier containing the code we want to execute asynchronously — in our case the lambda parameter.
The task is now implicitly submitted to the ForkJoinPool.commonPool(), or we can specify the Executor we prefer as a second parameter.
To know more about CompletableFuture, please read our Guide To CompletableFuture.
Заключение
Асинхронность, многопоточность и параллелизм — очень мощные и полезные инструменты, которые каждый день делают нашу жизнь лучше. Однако они хранят в себе массу опасностей, которые могут стать причиной катастрофы (буквально), — этому будет посвящена отдельная статья серии.
Учитывая сложность этих инструментов, понадобится не одна статья, чтобы их объяснить. Я постараюсь не только показать, как их использовать, но и помочь на более глубоком уровне понять принципы их работы.
Многое об АМП вы можете узнать на нашем курсе «Профессия C#-разработчик». Там вы освоите все инструменты, необходимые программисту на C#, чтобы постепенно стать профессионалом.