Все о ядре ос linux
Содержание:
Как собрать модуль вместе с относящимися к нему программами?
Часто требуется собрать не только сам модуль, но и несколько пользовательских программ, используемых совместно с модулем (тесты, утилиты, и т.д.). Зачастую в таком сценарии модуль и пользовательские программы используют общие файлы определений (заголовочные файлы). Вот как выглядит фрагмент Makefile для сборки в одном рабочем каталоге модуля и всех использующих его программ (архив ioctl.tgz, который будет рассматриваться в ближайшем будущем).:
Листинг 3. Одновременная сборка модуля и пользовательских программ
...
TARGET = hello_dev
obj-m      := $(TARGET).o

all: default ioctl

default:
        $(MAKE) -C $(KDIR) M=$(PWD) modules

ioctl:  ioctl.h ioctl.c
        gcc ioctl.c -o ioctl
...
Особенность такой совместной сборки заключается в том, что и модуль, и пользовательские процессы включают (с помощью директивы ) одни и те же общие и согласованные определения (пример, в том же архиве ioctl.tgz):
#include "ioctl.h"
Такой связующий файл содержит общие определения, как для кода пространства ядра, так и для пользовательских приложений. В качестве примера показано содержимое файла ioctl.h:
typedef struct _RETURN_STRING {
   char buf;
} RETURN_STRING;
#define IOCTL_GET_STRING _IOR( IOC_MAGIC, 1, RETURN_STRING )
В связи с этим может возникнуть определенная проблема, так как при сборке приложений и модулей (использующих совместные определения) для поиска системных () заголовочных файлов используются разные каталоги по умолчанию: /usr/include для процессов и /lib/modules/`uname -r`/build/include для модулей. Приемлемым решением будет включение в общий заголовочный файл (ioctl.h) фрагмента подобного вида:
Листинг 4. Условные определения для ядра и для приложений
#ifndef __KERNEL__         // приложения из пространства пользователя
// это /usr/include/linux/types.h ! :
#include <linux/types.h>
#include <string.h>
...
#else                      // модули ядра
...
#include <linux/errno.h>
// а это уже /lib/modules/`uname -r`/build/include/linux/types.h ! :
#include <linux/types.h>
#include <linux/string.h>
...
#endif
При всей схожести имён заголовочных файлов (а иногда и полном совпадении, например: ) это будут включения из абсолютно разных наборов API (API разделяемых библиотек *.so для пространства пользователя и API ядра — для модулей).
Добавление патчей
Патчи для ядра системы могут добавить поддержку оборудования, а в некоторых случаях повысить отзывчивость системы или внести другие улучшения. Для добавления, скачайте патч в директорию и преобразуйте в формат шаблона, добавив первой строкой патча заголовок шаблона:
/var/calculate/templates/file_patch
# Calculate format=diff env=install ac_install_patch==on&&merge(sys-kernel/calculate-sources)>=4.19
...
В заголовке указан формат , условие выполнения патча и проверка на версию устанавливаемого пакета.
Пример добавления патча
Пример добавления патча kernel_gcc_patch, расширяющего список процессоров для оптимизации ядра компилятором. Скачайте репозиторий, выполнив:
git clone https://github.com/graysky2/kernel_gcc_patch.git
Скопируйте файл с патчем в директорию шаблонов ядра:
cp kernel_gcc_patch/enable_additional_cpu_optimizations_for_gcc_v9.1+_kernel_v4.13+.patch /var/calculate/templates/kernel_gcc_patch
Добавьте заголовок шаблона к патчу:
/var/calculate/templates/kernel/patch/kernel_gcc_patch
# Calculate format=diff env=install ac_install_patch==on&&merge(sys-kernel/calculate-sources)>=4.19
...
Установите исходный код ядра. Параметр запустит процесс установки в один поток, в логе которого можно увидеть вывод сообщения об успешном применении патча:
USE=»-vmlinuz -minimal» emerge -a —jobs=1 sys-kernel/calculate-sources
...
>>> Source configured.
 * Применение патчей Calculate утилитами для calculate-sources ...
 * Применение патча enable_additional_cpu_optimizations_for_gcc_v9.1+_kernel_v4.13+.patch
 * Утилиты Calculate изменили файлы:
 *      .config
 *      arch/x86/Kconfig.cpu
 *      arch/x86/Makefile
 *      arch/x86/Makefile_32.cpu
 *      arch/x86/include/asm/module.h
>>> Compiling source in /var/calculate/tmp/portage/sys-kernel/calculate-sources-5.4.12/work/linux-5.4.12-calculate ...
...
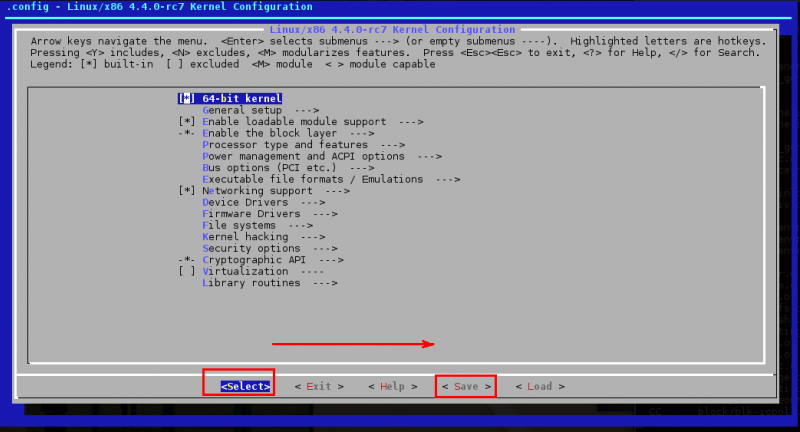
Выполните настройку ядра, выбрав ваш процессор из нового списка:
cl-kernel
Перейдите в раздел . Вы увидите, что список доступных CPU существенно расширился.
Скриншот

После сохранения настроек ядро будет собрано. Патч и обновлённые настройки ядра будут использованы и во время сборки пакета из исходного кода.
Модули ядра
Модуль ядра — объект, содержащий код, который расширяет функциональность запущенного ядра. Посмотреть загруженные в данный момент модули можно выполнив . Подробную информацию по модулю можно вывести, выполнив . Для того, чтобы модуль ядра подгружался автоматически во время загрузки системы, создайте файл с расширением в директории в котором перечислите отдельными строками модули и по необходимости параметры к ним. Пример:
/etc/modprobe.d/custom.conf
options <имя модуля> <параметр>=<значение>
Посмотреть список доступных опций модуля можно, используя утилиту . Пример определения доступных параметров модуля snd-intel8x0:
modinfo -p snd-intel8x0
index:Index value for Intel i8x0 soundcard. (int)
id:ID string for Intel i8x0 soundcard. (charp)
ac97_clock:AC’97 codec clock (0 = whitelist + auto-detect, 1 = force autodetect). (int)
ac97_quirk:AC’97 workaround for strange hardware. (charp)
buggy_semaphore:Enable workaround for hardwares with problematic codec semaphores. (bool)
buggy_irq:Enable workaround for buggy interrupts on some motherboards. (bint)
xbox:Set to 1 for Xbox, if you have problems with the AC’97 codec detection. (bool)
spdif_aclink:S/PDIF over AC-link. (int)
inside_vm:KVM/Parallels optimization. (bint)
enable: (bool)
joystick: (int)
Пример настройки загрузки модуля snd-intel8x0 с установленным значением параметра ac97_clock:
/etc/modprobe.d/snd-intel8x0.conf
options snd-intel8x0 ac97_clock=48000
Для того, чтобы отключить загрузку модулей, добавьте их в файл . Пример отключения загрузки модуля usblp:
/etc/modprobe.d/blacklist.conf
blacklist usblp
Параметры компиляции
Параметры компиляции модуля можно переопределить, изменив переменные, определённые в сценарии, выполняющем сборку, например:
EXTRA_CFLAGS += -O3 -std=gnu89 —no-warnings
Таким же образом можно дополнить определения необходимых препроцессорных переменных (которые сработают в собираемом коде), специфических для сборки модуля:
EXTRA_CFLAGS += -D EXPORT_SYMTAB -D DRV_DEBUG
(обратите внимание на знак +=). Примечание: Откуда берутся переменные, не определённые явно в тексте файла Makefile, как, например, ? Или откуда берутся правила сборки по умолчанию (как в примере использования ассемблерного кода, представленном в предыдущей статье)? И как можно посмотреть эти правила? Утилита make имеет множество значений по умолчанию (переменных, суффиксов и т.д.), важнейшими из которых являются правила обработки суффиксов, а также определения внутренних переменных окружения
Вся эта информация называется базой данных make и может быть выведена по ключу. Но объем выведенной информации будет очень большой, поэтому разумно отправить этот вывод в файл, а уже потом изучить его:
Примечание: Откуда берутся переменные, не определённые явно в тексте файла Makefile, как, например, ? Или откуда берутся правила сборки по умолчанию (как в примере использования ассемблерного кода, представленном в предыдущей статье)? И как можно посмотреть эти правила? Утилита make имеет множество значений по умолчанию (переменных, суффиксов и т.д.), важнейшими из которых являются правила обработки суффиксов, а также определения внутренних переменных окружения. Вся эта информация называется базой данных make и может быть выведена по ключу . Но объем выведенной информации будет очень большой, поэтому разумно отправить этот вывод в файл, а уже потом изучить его:
Листинг 1. Определения внутренних переменных окружения make
$ make -p >make.suffix
make: *** Не заданы цели и не найден make-файл.  Останов.
$ cat make.suffix
# GNU Make 3.81
...
# База данных Make, напечатана Thu Apr 14 14:48:51 2011
...
CC = cc
LD = ld
AR = ar
CXX = g++
COMPILE.cc = $(CXX) $(CXXFLAGS) $(CPPFLAGS) $(TARGET_ARCH) -c
COMPILE.C = $(COMPILE.cc)
...
SUFFIXES := .out .a .ln .o .c .cc .C .cpp .p .f .F .r .y .l .s .S
.mod .sym .def .h .info .dvi .tex .texinfo .texi .txinfo .w .ch...
# Implicit Rules
...
%.o: %.c
#  команды, которые следует выполнить (встроенные):
        $(COMPILE.c) $(OUTPUT_OPTION) $<
...
Теперь можно использовать все эти переменные в собственных сценариях сборки Makefile.
Совместимость
Задуманное изначально не как многоплатформенное, ядро Linux на данное время перенесено на очень широкий круг архитектур, запускается на широком спектре оборудования от iPAQ (карманный компьютер) до IBM S/390 (высокопроизводительный мейнфрейм). Системы на основе Linux используются в качестве основных почти на всех суперкомпьютерах (более 99 % списка TOP500), в том числе и на самом мощном — Summit.
Изначально Linux разрабатывался для 32-битных x86-совместимых ПК; на сегодняшний день различные версии ядра Linux запускаются на следующих процессорных архитектурах:
-
ARM:
- Acorn: Archimedes, A5000, RiscPC;
- StrongARM, Intel XScale и тому подобных;
- Axis Communications CRIS;
- DEC Alpha;
- HP PA-RISC;
- Hitachi: SuperH (SEGA Dreamcast), H8/300;
- IBM System/390;
- IBM zSeries-мэйнфреймы;
- Intel и выше: IBM PC и совместимые с процессорами:
- , , а также AMD, Cyrix, TI и IBM-варианты;
- серия Pentium;
- Core, Core2 Duo в 32- и 64-битных версиях;
- AMD , K5, K6, Athlon (все 32-битные версии), Duron;
- AMD64: 64-битная технология AMD (также известная как x86-64);
- Cyrix 5×86, 6×86 (M1), 6x86MX и MediaGX (National/AMD Geode) серия;
- VIA C3 и последующие процессоры;
- Microsoft Xbox (Pentium III);
- Intel IA-64;
-
MIPS;
- Silicon Graphics, Inc.;
- Cobalt Qube, Cobalt RaQ;
- Sony/Toshiba/IBM — Emotion Engine и Cell, используемые в PlayStation 2 и PlayStation 3 соответственно;
- DECstation
- и некоторые другие;
-
Motorola и выше:
- более новые Amiga: A1200, A2500, A3000, A4000;
- Apple Macintosh II, LC, Quadra, Centris и ранняя серия Performa;
- рабочие станции Sun Microsystems серии 3 (экспериментальная, с использованием Sun-3 MMU);
- NEC v850e;
- Renesas M32R;
-
PowerPC и IBM POWER:
- все новые компьютеры Apple (все оснащённые PCI Power Macintoshes, ограниченная поддержка NuBus Power Macs),
- клоны PCI Power Mac, разработанные Power Computing, UMAX и Motorola;
- IBM RS/6000, iSeries- и pSeries-системы;
- Pegasos I и II системы;
- некоторые встроенные системы PowerPC;
- Qualcomm Hexagon
- SPARC и UltraSPARC: Sun 4-series, SPARCstation/SPARCserver, Ultra-, Blade- и Fire-серии рабочих станций и серверов.
Инсталляция модуля
Выше, в сценарии рекурсивной сборки, в качестве целей сборки были названы и . Инсталляция модуля должна состоять из следующих шагов:
- скопировать собранный файл модуля (*.ko) в его местоположение в иерархии модулей, часто это, например, каталог /lib/modules/`uname -r`/misc;
- обновить информацию о зависимостях модулей (в связи с добавлением нового), что делается вызовом утилиты .
Но если в Makefile создаётся цель для инсталляции модуля, то обязательно должна быть создана и обратная цель для деинсталляции: лучше не иметь автоматической возможности инсталлировать модуль (и делать это вручную), чем автоматизировать процесс установки, не имея возможности удалить установленный модуль! Для деинсталляции модуля требуется:
- удалить файл модуля (*.ko) из его местоположения в иерархии модулей;
- обновить информацию о зависимостях модулей вызовом .
В самом же файле Makefile эти цели могут быть записаны, как показано в листинге 6:
Листинг 6. Цели сборки: инсталляция и деинсталляция
CURRENT = $(shell uname -r)
KDIR = /lib/modules/$(CURRENT)/build
PWD = $(shell pwd)
DEST = /lib/modules/$(CURRENT)/misc
TARGET = ...

obj-m   := $(TARGET).o
default:
        $(MAKE) -C $(KDIR) M=$(PWD) modules

install:
        cp -v $(TARGET).ko $(DEST)
        /sbin/depmod -v | grep $(TARGET)
        /sbin/insmod $(TARGET).ko
        /sbin/lsmod | grep $(TARGET)

uninstall:
        /sbin/rmmod $(TARGET)
        rm -v $(DEST)/$(TARGET).ko
        /sbin/depmod
Эти цели повторяются из проекта в проект, так что в большинстве демонстрируемых примеров мы уже не будем к ним возвращаться.
О системе /sys
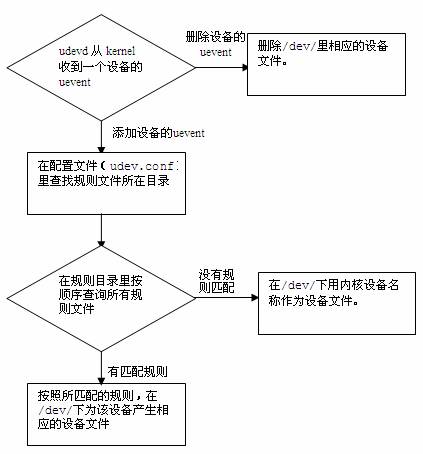
Одно из главных «нововведений» в ядре, начиная с версии 2.6, — это появление единой унифицированной модели представления устройств в Linux. Основные составляющие данной модели — это файловая система sysfs и дуальный к ней (поддерживаемый ею) пакет пользовательского пространства udev. Модель устройств— это единый механизм для представления устройств и описания их топологии в системе. Декларируется множество преимуществ, которые обусловлены созданием единого представления устройств:
- уменьшается дублирование кода;
- используется стандартный механизм для выполнения общих, часто встречающихся функций, таких как счетчики использования;
- возможность систематизации всех устройств в системе, возможность просмотра состояний устройств и определения, к какой шине то или другое устройство подключено;
- обеспечивается возможность связывания устройств с их драйверами и наоборот;
- появляется возможность разделения устройств на категории в соответствии с различными классификациями, таких как устройства ввода, без знания физической топологии устройств;
- обеспечивается возможность просмотра иерархии устройств от листьев к корню и выключения питания устройств в правильном порядке.
Файловая система sysfs возникла первоначально из-за необходимости обеспечивать последовательность действий при динамическом управлении электропитанием (иерархия устройств при включении-выключении) и для поддержки горячего подключения устройств. Но получившаяся в результате модель оказалась более функциональной, чем ожидалось изначально. Сама по себе эта система является весьма сложной и объёмной, и о ней следовало бы написать отдельную книгу. Но в контексте создания модулей ядра нас интересует, в первую очередь, возможность создания интерфейса из модуля к файловым именам в файловой системе /sys. Эта функциональность очень похожа на ту, которая используется модулем для создания файловых имен в подсистеме /proc.
CFS
За все время существования Linux сменил множество различных алгоритмов планирования процессов, от самых простых и примитивных до алгоритмов, способных предугадывать будущие потребности процессов в ресурсах процессора и равномерно распределять время между всеми процессами. Однако наиболее значимым стал переход к использованию планировщика CFS, который позволил вплотную приблизить работу системы к идеалу.
CFS (Completely Fair Scheduler) был разработан Инго Молнаром под впечатлением от планировщика Rotating Staircase Deadline за авторством непризнанного Linux-хакера Кона Коливаса, известного своим нестандартным подходом к реализации внутриядерных механизмов. CFS отличается простотой, отсутствием какой-либо эвристики и удивительной способностью к правильной балансировке нагрузки. В системе с CFS можно спокойно запустить компиляцию в несколько потоков, форк-бомбу, фильм и при этом спокойно сидеть в интернете, практически не замечая каких-либо притормаживаний. Нагрузка будет распределена полностью равномерно.
Достигается это за счет простого алгоритма распределения времени, в котором процессы встают в очередь в том порядке, в котором они использовали время процессора в предыдущий раз. Наименее жадные получают процессор первыми, наиболее жадные — последними. Поэтому, например, компилятор и форк-бомба будут находиться ближе к концу в очереди, а интерактивные процессы, которые большую часть времени простаивают, ожидая ввода пользователя или данных с диска, — к началу, что является разумным, но полностью автоматизированным разделением времени.
CFS был включен в ядро, начиная с версии 2.6.23, и, вероятнее всего, еще не скоро покинет его (если это вообще случится). Разработчики FreeBSD портировали его в свою систему, но, к сожалению, забросили разработку в пользу собственного планировщика ULE.
Дальнейшее изучение
Это был лишь общий обзор процессов управления модулями в ядре. Лучшим источником дополнительной информации об управлении модулями является сам исходный код. Основные функции управления модулями содержатся в ./linux/kernel/module.c (и соответствующем файле заголовка ./linux/include/linux/module.h). Несколько функций, зависящих от архитектуры, находятся в ./linux/arch/<arch>/kernel/module.c. Наконец, функция автозагрузки ядра (которая автоматически загружает модуль из ядра при необходимости) находится в файле ./linux/kernel/kmod.c. Эта функция включается при помощи параметра настройки .
Похожие темы
- Anatomy of Linux loadable kernel modules (EN) — оригинал статьи.
- Посетите блог Расти Рассела «Bleeding Edge», посвященный его текущим разработкам для ядра Linux. Расти – ведущий разработчик новой архитектуры модулей Linux.(EN)
- Руководство по программированию модулей ядра Linux, хотя слегка устарело, содержит большое количество подробной информации о загружаемых модулях и их разработке. (EN)
- В статье «Доступ к ядру Linux с помощью файловой системы /proc»
(developerWorks, март 2006 г.) приведен подробный обзор программирования загружаемых модулей ядра с использованием файловой системы /proc. -
Подробнее узнать о работе системы вызовов можно из статьи
«Kernel command using
Linux system calls» (EN)
(developerWorks, март 2007 г.). - Чтобы узнать больше о ядре Linux, прочтите первую статью Тима «Анатомия ядра Linux» (developerWorks, июнь 2007 г.) из этой серии, в которой дан общий обзор ядра Linux и некоторых его интересных особенностей.
- Прочитайте великолепное введение в формат ELF »
Standards
and specs: An unsung hero: the hardworking ELF» (EN) (developerWorks, декабрь 2005 г.). ELF является стандартным форматом объектных файлов для Linux. ELF — это гибкий формат файлов, охватывающий исполняемые образы, объектные файлы, общие библиотеки и даже дампы ядра. Более подробную информацию можно найти также в справочнике по формату (EN) (документ PDF) и в подробной
книге по форматам ELF (EN). - На сайте
Captain’s Universe
имеется великолепное введение в сборку загружаемых модулей с примерами make-файлов. Процесс сборки загружаемых модулей в ядре версии 2.6 был изменен (к лучшему).(EN) - Имеется несколько утилит для установки, удаления и управления модулями.(EN) Модули устанавливаются в ядро командой
, а удаляются командой
. Для запроса о том, какие модули сейчас загружены в ядро, используйте команду
. Поскольку модули могут зависеть друг от друга, существует команда
для создания файла зависимостей. Для автоматической загрузки зависимых модулей до загрузки основного модуля используйте команду
(оболочка команды ). Наконец, прочесть информацию загружаемого модуля можно при помощи команды
. - Статья «Linkers and Loaders» (EN)
в журнале Linux Journal (ноябрь 2002 г.) содержит замечательное введение в работу редакторов связей и загрузчиков, использующих файлы ELF (включая разрешение символов и перемещение). -
В
разделе Linux сайта developerWorks
имеются и другие ресурсы для Linux-разработчиков. Ознакомьтесь также с
самыми популярными статьями и руководствами. (EN) -
Ознакомьтесь с разделами
советов и
учебных пособий по Linux на developerWorks.
-
Используйте
ознакомительные версии ПО IBM,
которые можно загрузить непосредственно с developerWorks, в вашем следующем проекте разработки для Linux. (EN)
Как ускорить сборку ядра
Одним из главных факторов, влияющих на продолжительность сборки ядра, является скорость жёсткого
диска при записи великого множества коротких объектных файлов. Но оборудование многих компьютеров
позволяет использовать в качестве устройства хранения для сборки tmpfs (RAM диск):
$ free
             total       used       free     shared    buffers     cached
Mem:       4124164    1516980    2607184          0     248060     715964
-/+ buffers/cache:     552956    3571208
Swap:      4606972          0    4606972
$ df -m | grep tmp
tmpfs
Проверим такую возможность, для этого скопируем дерево исходных кодов в каталог
/dev/shm:
$ pwd
/dev/shm/linux-2.6.35.i686
$ time make bzImage
...
  HOSTCC  arch/x86/boot/tools/build
  BUILD   arch/x86/boot/bzImage
Root device is (8, 1)
Setup is 13052 bytes (padded to 13312 bytes).
System is 3604 kB
CRC 418921f4
Kernel: arch/x86/boot/bzImage is ready  (#1)

real    9m23.986s
user    7m4.826s
sys     1m18.529s
Как видно, время на сборку ядра сократилось до 10 минут (в 2.5 раза), что очень неплохо.
Ещё один способ существенно ускорить сборку ядра — это указать утилите
использовать при сборке ядра все доступные процессорные ядра:
$ make -j bzImage
...
Или, если вы хотите указать конкретное число ядер (например 4), задействованных в процессе сборки:
$ make -j4 bzImage
...
Но будьте осторожны с этим способом! Сборка не всех версии ядра успешно
завершается при параллельном использовании нескольких процессоров, что, возможно, связано с
некорректностью синхронизации ветвей при компиляции. Но экспериментальная проверка такой возможности
никак не навредит…
Особенности ядра Linux
Обычно конечные пользователи имеют дело с дистрибутивами Linux, которые незначительно отличаются между собой, в том числе по компонентам ядра (например, наличию/отсутствию определенных драйверов). Однако ядро в своей основе все-равно остается ядром Linux, его исходники предоставляет проект https://www.kernel.org/. Это совместный проект, к нему может присоединится каждый программист. Основным руководителем остается Линус Торвальдс.
С технической точки зрения, Linux – это ядро, а не операционная система. Linux + программы из проекта GNU рождают операционную систему GNU/Linux. Однако ее тоже не существует в чистом виде. Разработчики дистрибутивов дорабатывают на свой лад GNU/Linux, после чего получаются различные операционные системы-дистрибутивы. У каждого дистрибутива есть собственное имя (Ubuntu, Fedora и т. п.). Однако в основе всех этих систем лежит ядро Linux, поэтому все они принадлежат одному семейству Linux-систем.
Ядро Linux начал разрабатывать в 1991 году Линус Торвальдс. В дальнейшем оно развивалось и совершенствовалось многими людьми. Ядро Linux выпускается под лицензией GNU GPL.
Ядро Linux Unix-подобно, так как заимствовало идеи, заложенные в Unix, соответствует стандартам POSIX, а также по большей части написано на языке С.
У Linux монолитное ядро. Однако некоторые идеи микроядерной архитектуры тут также используются. Так драйверы устройств могут быть представлены в виде модулей и загружаться по требованию, а не при загрузки всего ядра.
Ядро выпускается в виде стабильных и разрабатываемых версий. В стабильных обычно исправлены ошибки, добавлены новые драйверы устройств. До недавнего времени четное второе число в названии ядра, говорило, что оно стабильно. Нечетное число обозначало разрабатываемую нестабильную версию. В 2011 году от такого подхода к нумерации версий отказались.
Опытные пользователи дистрибутивов Linux нередко сами скачивают и устанавливают себе новое ядро. Для этого они сначала распаковывают исходные коды, затем выполняют конфигурацию, потом компилируют, размещают в загрузочном каталоге и изменяют настройки загрузчика.
Конфигурируют ядро с целью включения, отключения или компиляции в виде модуля какого-либо драйвера или функции. Другими словами, «ядро под себя» не будет содержать лишних драйверов для оборудования, которого нет.
Требуются ли собирать ядро?
Перед тем, как приступить к созданию модуля, программист (хотя бы для себя) должен ответить на следующие вопросы:
- требуется ли собирать ядро;
- следует ли освоить технику сборки ядра из исходного кода;
- следует ли вообще уметь устанавливать ядро из исходного кода.
Сборка и установка нового ядра в современных версиях Linux не связана с какими-либо сложностями. Но из-за этого данное действие утратило свое «реальное» значение, превратившись в ложно понимаемый критерий профессионализма, и зачастую стало выполняться «просто так», без осознания ключевых принципов процесса сборки и установки ядра. Для сборки и тестирования модулей обязательная сборка самого ядра не требуется. Для работы с модулями достаточно наличия заголовочных файлов ядра (в точности соответствующих загруженной версии ядра!), а сам исходный программный код ядра не нужен.
Обычно заголовочные файлы, необходимые для разработки модулей, уже присутствуют в системе (это определяется предпочтениями авторов используемого Linux-дистрибутива). Но может оказаться, что исходный код ядра отсутствует, и в этом случае символьная ссылка /lib/modules/`uname -r`/build окажется неразрешённой, а каталог с исходным кодом ядра пустой.
$ ls /usr/src/kernels
$
В любом случае следует проверить наличие обязательных пакетов, как показано ниже, и при необходимости доустановить их из репозитария.
$ uname -r
2.6.35.14-95.fc14.x86_64
$ yum list all kernel-*
kernel-devel.x86_64      2.6.35.14-95.fc14           @updates
kernel-headers.x86_64    2.6.35.14-95.fc14           @updates
В этом списке нас интересуют значения kernel-headers и kernel-devel. Здесь же показано точное требуемое соответствие версий пакетов той версии ядра, в которой ведётся разработка и компиляция модулей. Если пакета нет, то его необходимо установить (как показано ниже на примере одного из пакетов):
Листинг 7. Установка обязательных пакетов ядра
# yum install kernel-devel.x86_64
...
Установка:
 kernel-devel         x86_64      2.6.35.13-95.fc14      updates      6.6 M
...
Объем загрузки: 6.6 M
Будет установлено: 24 M
...
Установлено:
  kernel-devel.x86_64 0:2.6.35.13-95.fc14
В листинге 7 показан пример установки для 64-разрядной системы. Точно определить пакеты, требующиеся для конкретной системы, можно с помощью регулярных выражений для шаблонов имён. В любом случае, необходимо убедиться, что в системе установлены заголовочные файлы, соответствующие версии исполняющейся системы.
Btrfs
Как бы хороша ни была еxt4, ее узкие места отлично понимают и прямо говорят, что она лишь переходный этап к файловым системам будущего, которые будут иметь концептуально иной дизайн и возможности. Наиболее близкий кандидат в такие ФС — это Btrfs, разрабатываемая под руководством компании Oracle в качестве альтернативы ZFS (разработка была начата еще до приобретения компании Sun, владеющей правами на ZFS).
Три основные изюминки этой ОС — отличная масштабируемость, плотная интеграция с менеджером томов и расширяемость. Как и еxt4, Btrfs базируется на идее экстентов, которая позволяет сделать управление данными эффективным даже для очень больших объемов данных и размеров файлов. Выделение inode в файловой системе происходит в полностью динамическом режиме, что снимает ограничение на общий объем файлов. Мелкие файлы могут быть размещены прямо в inode, так же как это сделано в Reizer4, поэтому производительность работы ФС с большим количеством небольших файлов остается очень высокой.
Как и в ZFS, размещение файлов производится по принципу copy-on-write (COW), а это означает, что файл никогда не перезаписывается, вместо этого при его модификации происходит выделение новых блоков данных для хранения измененных частей. Такой подход позволяет сделать процесс модификации файлов более эффективным, идеально подходит для SSD-накопителей с их ограниченным количеством циклов перезаписи, а также делает возможной такую технологию, как снапшоты, когда пользователь в любой момент может откатиться к предыдущей версии файловой системы или отдельных файлов.
Для гарантии целостности файловая система использует хеши данных и метаданных. Файловая система может иметь несколько корней (подтомов), благодаря чему одну файловую систему можно использовать для размещения нескольких виртуальных окружений или сэндбоксов. Уже реализован механизм прозрачной компрессии данных с помощью алгоритмов lzo и zlib, который позволяет сэкономить дисковое пространство и при этом поднять производительность ФС (распаковка данных происходит быстрее их чтения с диска). Реализована система онлайн-дефрагментации, а также динамического расширения и сжатия ФС по необходимости.
Чтобы сделать работу файловой системы поверх RAID-массивов более эффективной и повысить надежность, разработчики тесно интегрировали Btrfs с подсистемой управления томами Device Mapper. Такой дизайн позволяет консолидировать работу файловой системы и подсистемы RAID, в результате чего возрастает как производительность, так и надежность массива. Файловая система знает об используемой RAID-схеме, текущем состоянии дисков и балансирует нагрузку в зависимости от условий (например, наиболее используемые файлы будут автоматически перемещены на более производительный диск). Сбой в работе RAID-массива позволяет вовремя остановить операции ввода-вывода и восстановить свою работу, дождавшись переконфигурирования. В совокупности с контрольными суммами, которые файловая система хранит для каждого блока, RAID-массив на основе Btrfs становится крайне надежным.
На текущий момент Btrfs уже достаточно стабильна для повседневного применения и в некоторых тестах производительности обгоняет еxt4. Она использовалась в качестве основной ФС в мобильной платформе MeeGo и доступна для использования по умолчанию во многих дистрибутивах.
Согласно синтетическим тестам, ext4 остается самой производительной ФС в Linux